匹配模拟器
1. 概述
PGOS 提供了一个在规则集上线前验证规则集的模拟器。它把一份虚拟玩家数据集按线上匹配服务相同的逻辑回放一遍:规则集的调度方式、搜索超时和规则放宽(expansion)都与线上一致,然后报告每张票据的最终去向。
匹配模拟器执行以下任务:
- 用一个或多个规则集回放数据集,票据的入场方式和玩家延迟均可配置。
- 汇总模拟结果:成功率、对局数、每张票据的去向,以及未匹配成功的票据为什么失败。
- 将匹配结果导出为
csv文件(每名玩家一行),供开发者进行数据后处理。
通过使用匹配模拟器,开发者可以了解所编写规则集的倾向:哪些类型的票据能很快匹配成功,哪些类型的票据会因为难以找到相近的票据而超时。
在 Matchmaking Simulator 页面点击 Tutorial,可以查看跑通模拟的分步教程。
2. 创建模拟案例
点击 Add Simulator Case,在弹框中填写:
| 字段 | 说明 |
|---|---|
| Match Config | 可选。选择后会自动选中它的规则集,并带出它的搜索超时。模拟器运行的是规则集而不是 Match Config,这里只是省去手动对齐的麻烦。 |
| Ruleset(s) | 必填。一个或多个规则集。选择多个时,它们声明的玩家属性必须一致,模拟器会按照多规则集策略运行,与线上匹配一致。 |
| Fake Player Dataset | 必填。只有包含所选规则集声明的全部玩家属性的数据集才能被选择。 |
| Ticket Arrival | 票据如何进入匹配池,见 Ticket Arrival。 |
| Latency Source | 玩家延迟的来源,见 Latency Source。 |
| Searching Timeout | 票据在匹配池中最多停留多久。所有票据共用这个值,与 Match Config 的搜索超时一致。Auto 取规则集 expansions 中最大的 waitTimeSeconds 再加 30 秒。 |
| Simulated Duration | 模拟多长时间。Auto 取最后一张票据的入场时间加上搜索超时。模拟按真实时间运行,所以这大致也是案例的运行时长。 |
2.1 Ticket Arrival
| 选项 | 行为 |
|---|---|
| From dataset | 默认。按数据集中的 enter_offset_ms 列回放,票据按线上当时的节奏进入匹配池。 |
| Fake | 忽略 enter_offset_ms,按下方设置现场生成入场时间,并按数据集的行顺序分配给票据。 |
| All at once | 所有票据同时进入匹配池。适合在同一份数据集上对比「集中涌入」和「逐步进入」。 |
选择 Fake 后,需要选择一种分布:
- Uniform:在 Arrival Span(第一张到最后一张票据的秒数)内随机均匀分布。
- Poisson:按给定的 Arrival Rate(每秒票据数)产生指数分布的间隔,最接近线上流量。
- Constant:按给定的 Arrival Rate 等间隔入场。
组队票据无论包含几名玩家,在入场速率中都只算一张。相同的数据集和参数每次生成的入场时间都相同,重跑的结果可以相互比较。弹框还会估算全部票据入场需要多长时间。
- 如果数据集没有非 0 的
enter_offset_ms,From dataset 会让所有票据同时入场,效果与 All at once 相同。此时请选择 Fake 让票据分散入场,弹框也会给出提示。 - 运行中的案例默认最多运行 1 小时,之后才入场的票据不会进入匹配池。数据集较大时,请缩短入场跨度或提高入场速率。
2.2 Latency Source
| 选项 | 行为 |
|---|---|
| From dataset | 默认。使用数据集中的 latency.<region> 列,两次运行看到的输入相同。 |
| Fake | 忽略数据集中的延迟列,每名玩家在每个 region 上的延迟都按你设置的分布生成。 |
| None | 不注入任何延迟,相当于客户端从未上报测速。 |
选择 Fake 后,每个 region 添加一行(最多 16 个),并以毫秒为单位设置分布:
- Normal:填写 Mean(均值)和 Std dev(标准差),结果截断到 [Min, Max]。
- Uniform:在 [Min, Max] 内均匀分布。
region 名只能包含字母、数字、_、. 和 -。生成的延迟在同一个案例中是固定的:用相同设置重跑,每名玩家得到的延迟都相同。
- 只有当一个对局提案中的所有玩家在某个共同的 region 上都有延迟数据时,
latencyRule才可能通过。如果数据集没有latency.<region>列,选择 From dataset 或 None 会让所有latencyRule都不通过,使用了它的规则集将一局都匹配不成。选中这样的数据集后,弹框会给出警告。 - 选择 Fake 时,
latencyRule能否通过取决于你设置的分布,以及规则的maxLatency/maxDistance。请不要用 Fake 的结果得出关于真实延迟的结论。
3. 排队与生命周期
模拟案例由模拟器服务排队执行。每个服务实例同时只运行一个案例,多个实例之间并行运行。列表右上角会显示所有 title region 中正在运行和正在等待的案例数,队列空闲时不显示。排队中的案例还会显示前面还有几个案例。
| 状态 | 含义 |
|---|---|
| Queued | 等待空闲的服务实例。 |
| Running | 正在模拟,结果列显示进度条。 |
| Completed | 已结束。请查看下方的结束原因,确认结果是否完整。 |
| Cancelled | 被用户中止。 |
| Aborted | 因系统错误失败,例如数据集无法加载。 |
| Terminated | 运行该案例的服务实例意外停止,案例被回收。 |
每个产生了结果的案例都会显示以下结束原因之一:
- Pool drained:每张票据都已有结论,成功率是完整的。
- Reached the simulated duration:模拟结束时仍有票据留在匹配池中,计算成功率时请注意分母。
- Aborted: wall clock budget exceeded:案例运行超过 1 小时被停止,结果不完整,请不要据此下结论。
- Cancelled while running:只回放了部分流量,成功率不具有可比性。
在列表的 Operation 列可以管理案例:
- Cancel:将排队中的案例移出队列,或停止运行中的案例。被停止的案例会保留已产生的部分结果。
- Rerun:打开创建弹框,并预填该案例的设置。
- Download CSV:导出结果,见数据后处理。
4. 查看模拟结果
4.1 创建示例规则集
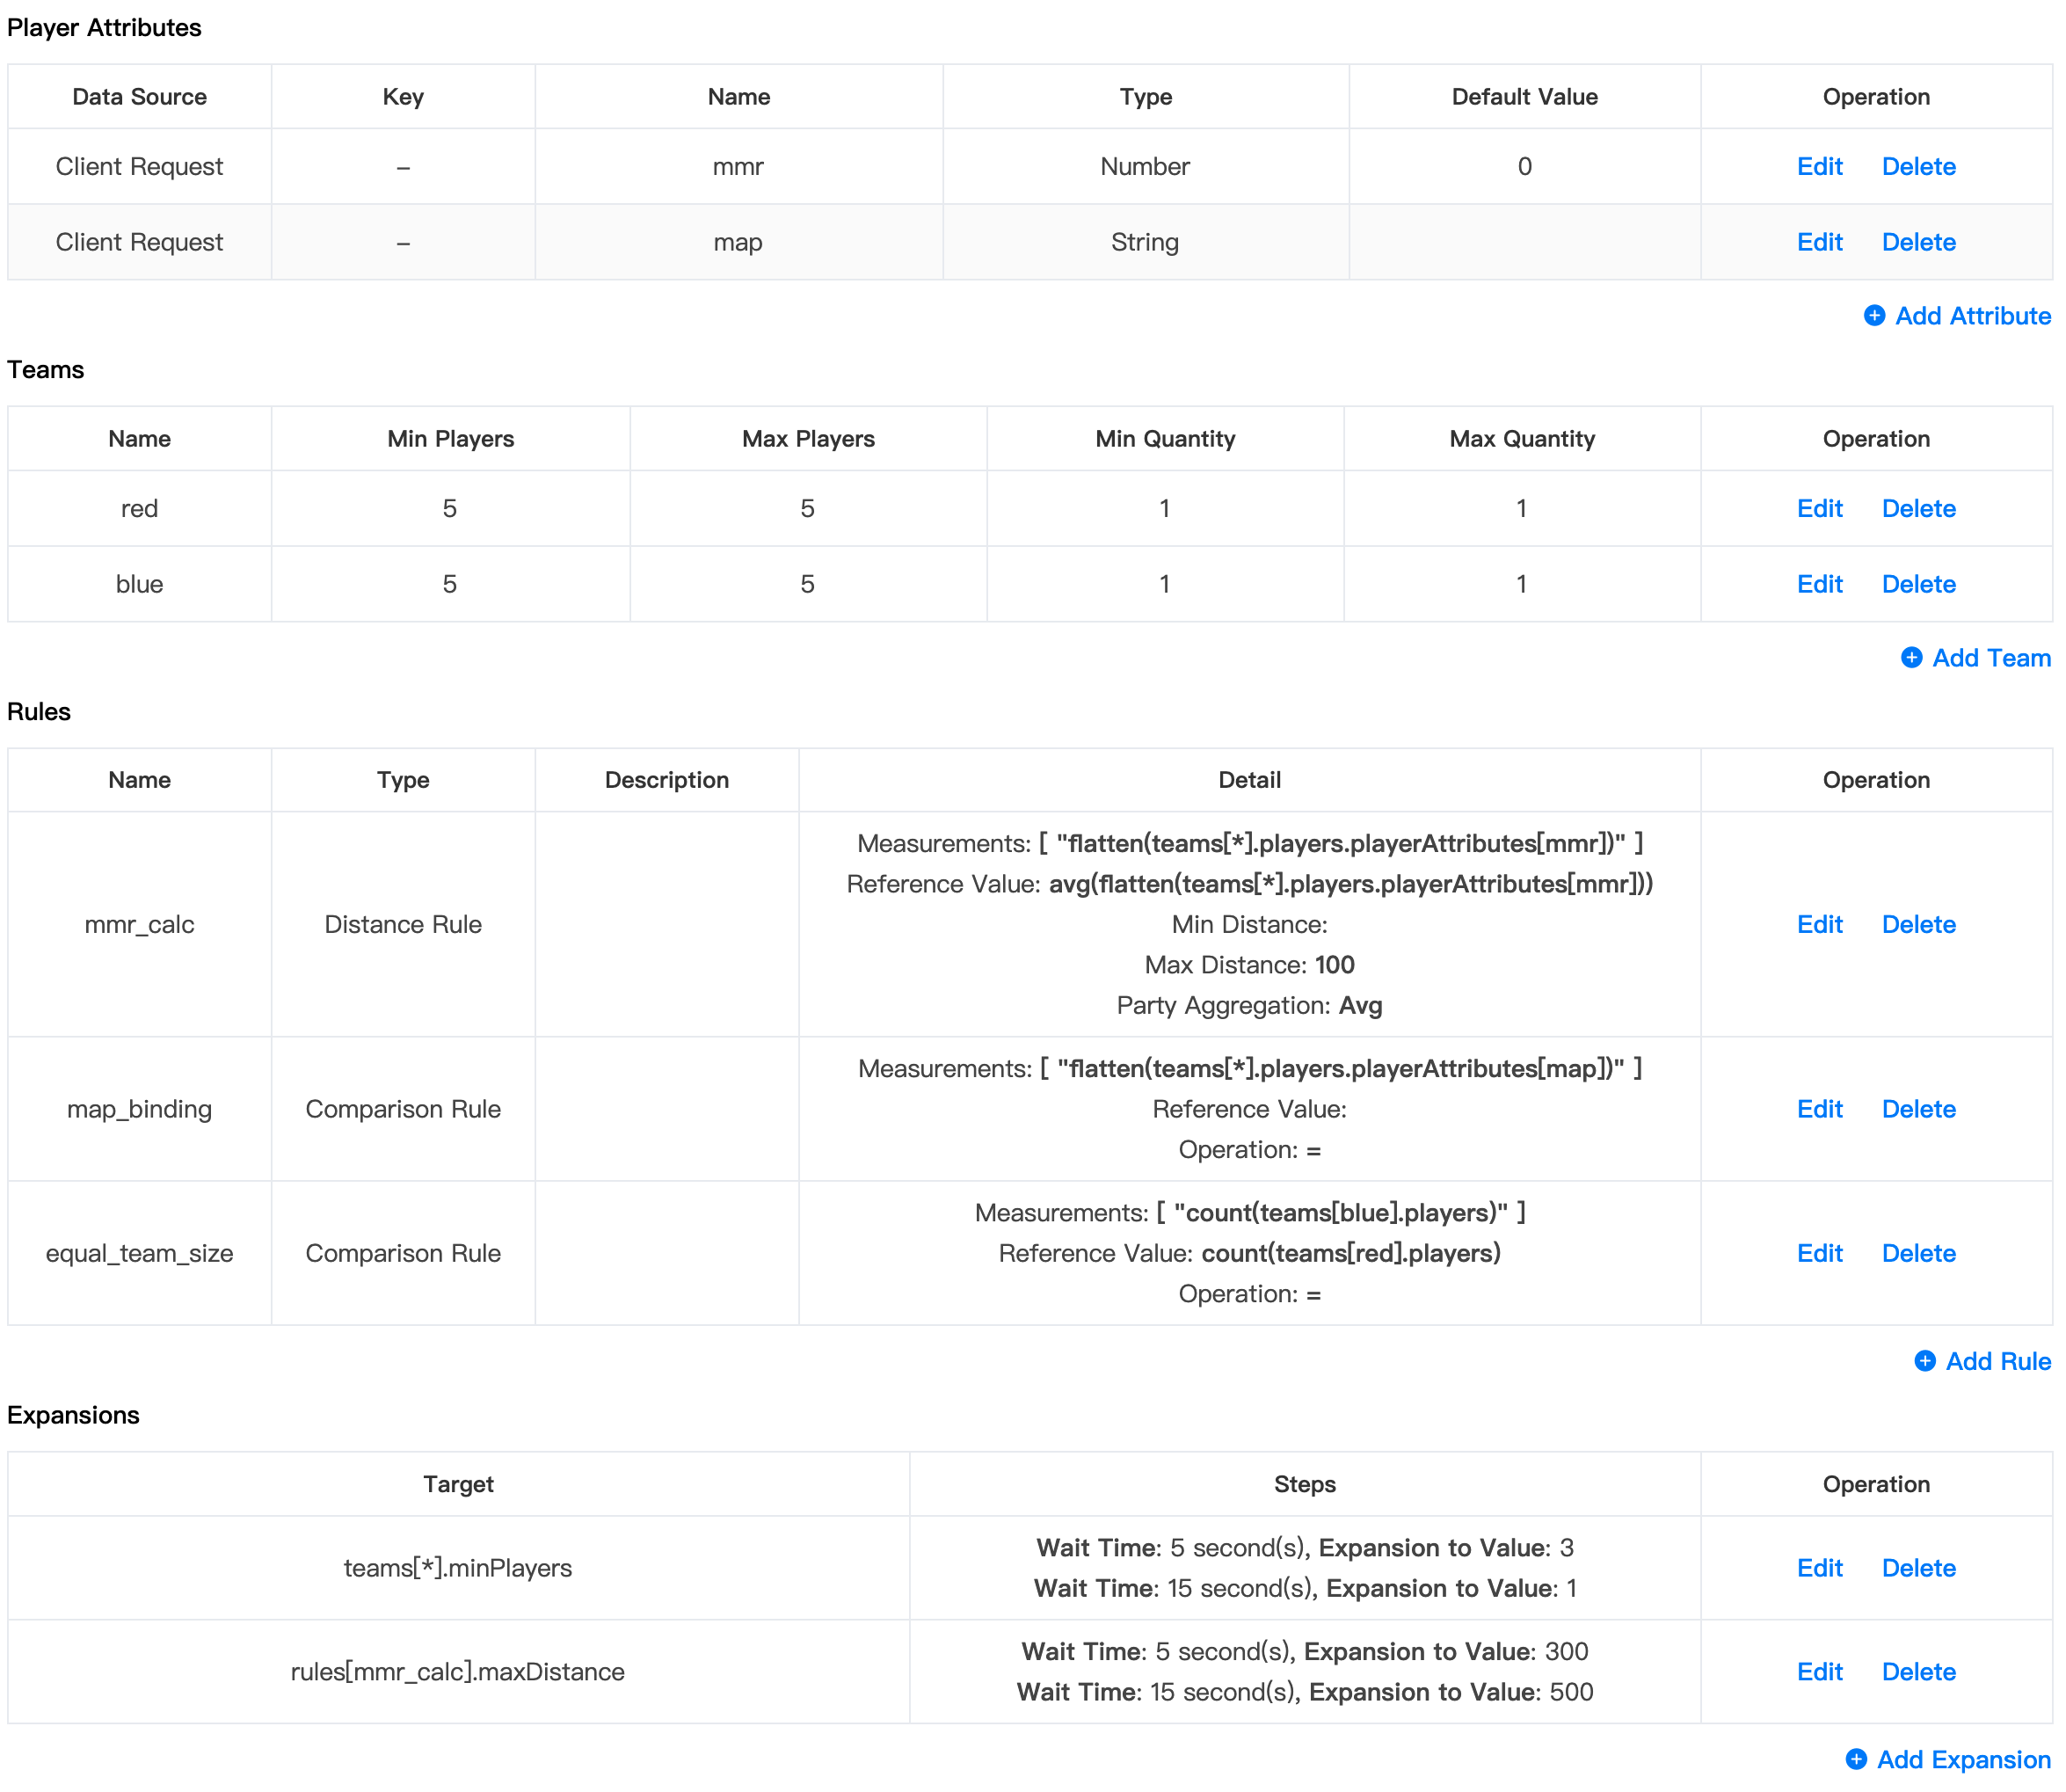
让我们以这个 5v5 规则集为例:
- 定义了两个属性:
mmr和map。 - 两个队伍,默认为 5v5,如果 15 秒后没有匹配到票据则放宽至 1v1。
- 一个引用对局中玩家
mmr的距离规则,限制mmr的最大距离为 100,15 秒后放宽至 500。 - 一个引用
map的比较规则,将选择相同map的玩家分到同一对局中。 - 一个使用
count函数的比较规则,确保两个队伍拥有相同数量的玩家。
4.2 创建虚拟玩家数据集
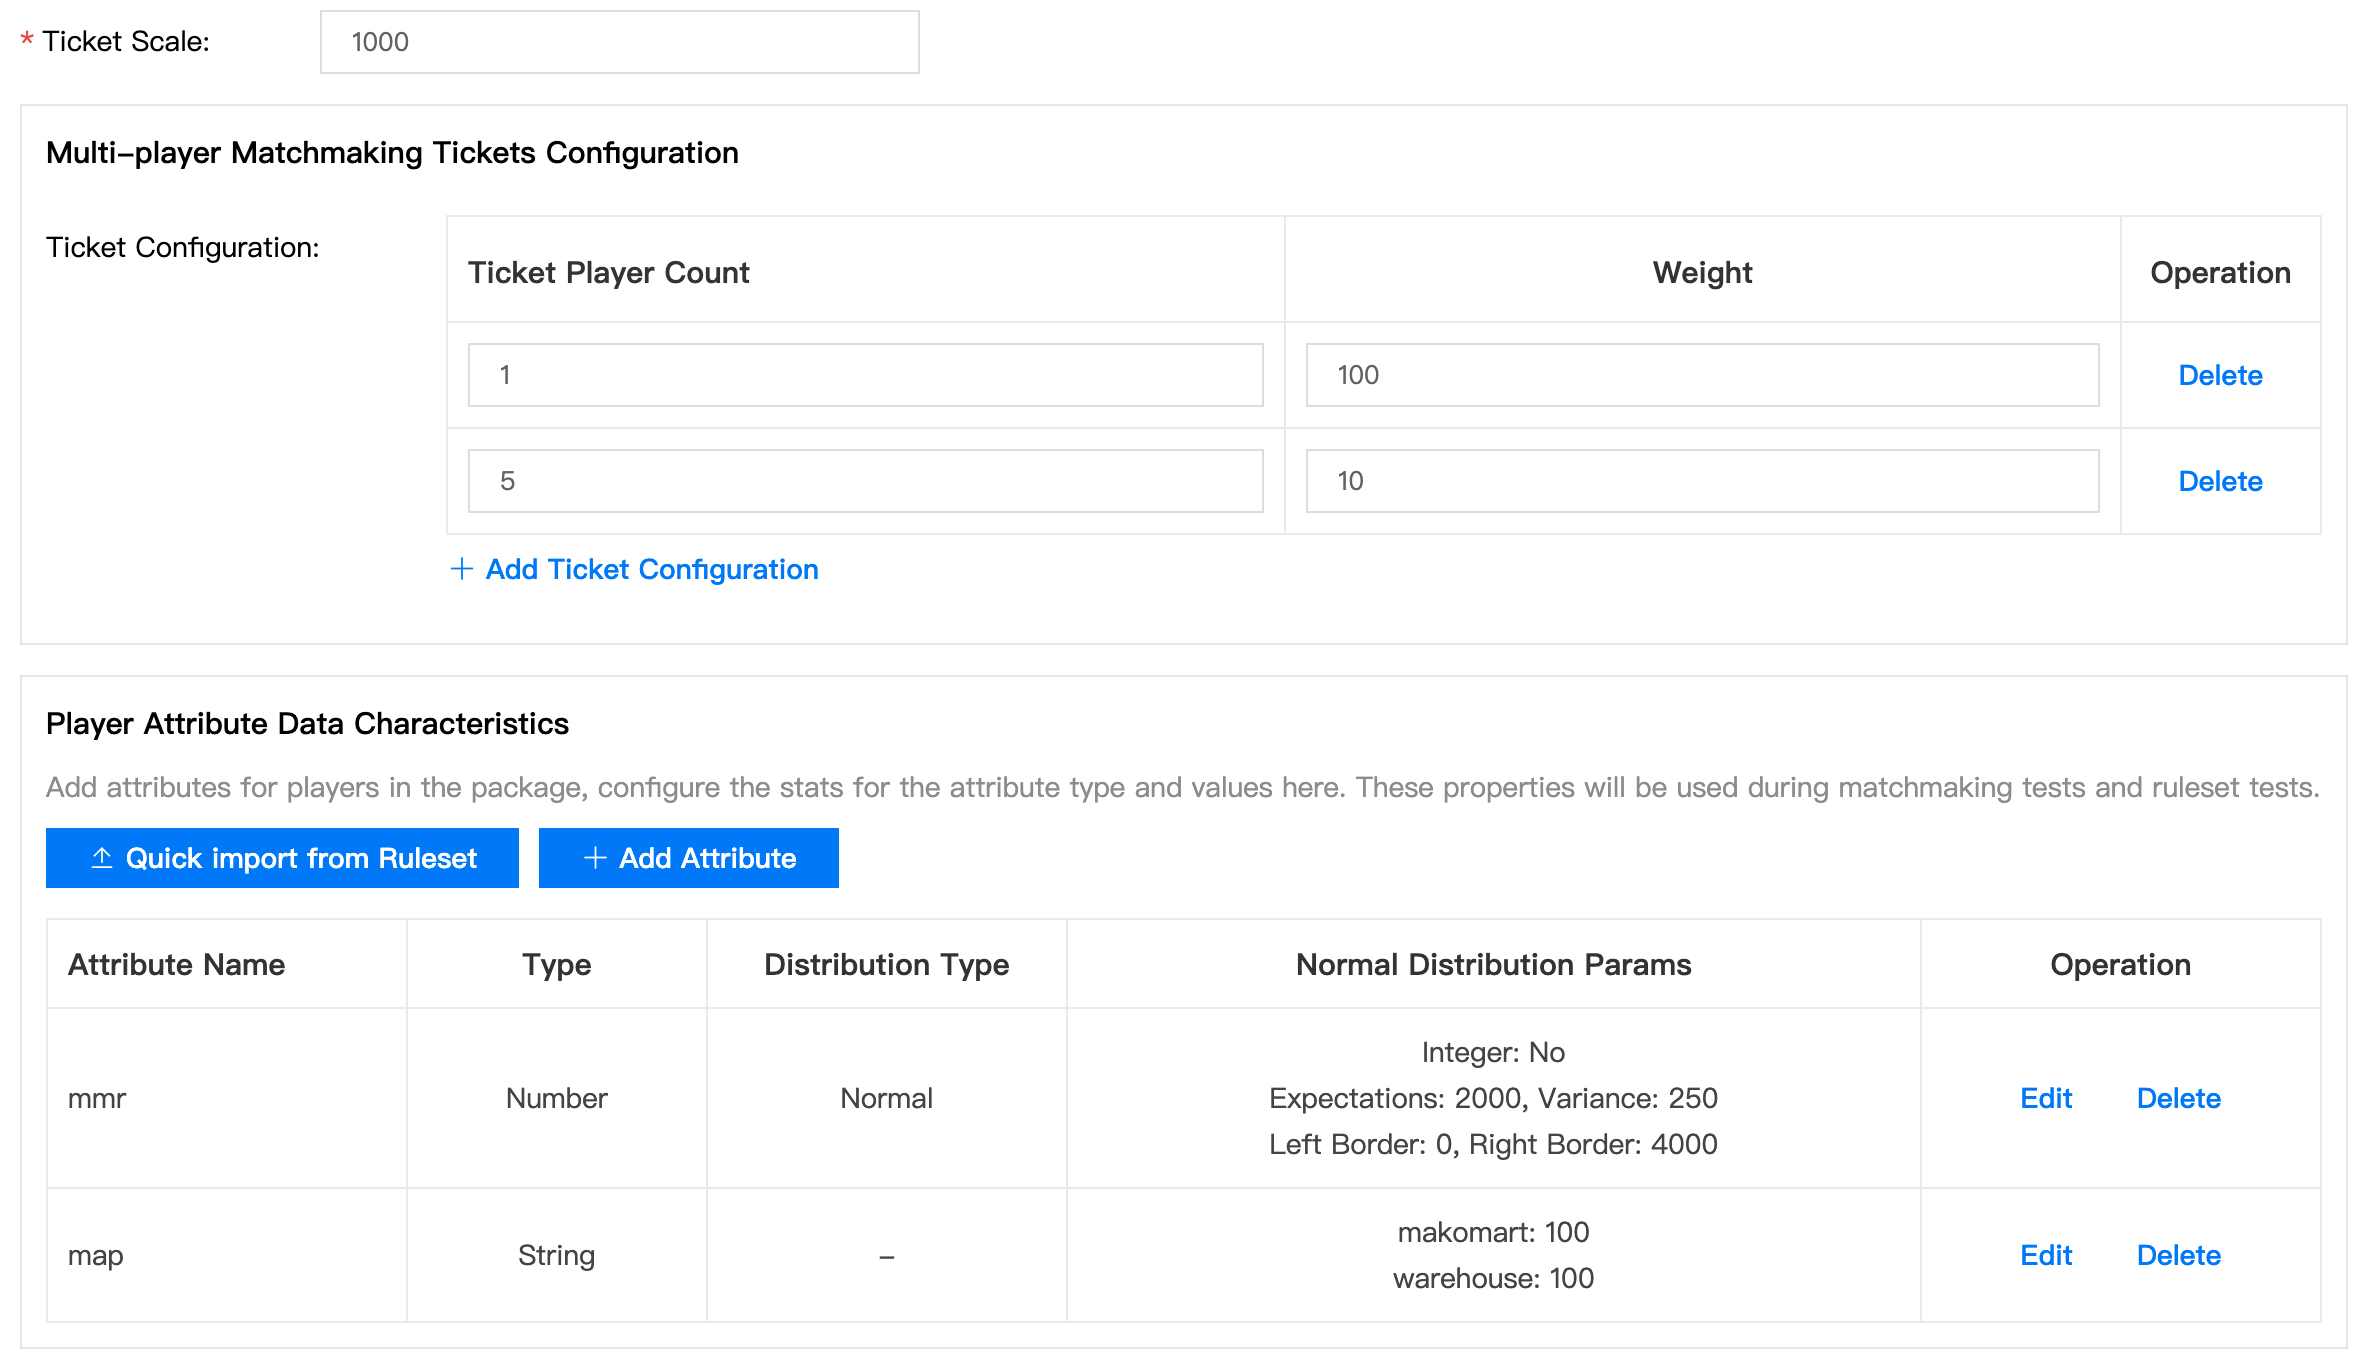
接下来我们创建一个包含 1000 张票据的虚拟玩家数据集:
- 混合单人票据和 5 人组队票据,比例设为 100:10
- 从规则集中快速导入属性定义
mmr通常符合正态分布,我们将avg设为 2000,stddev设为 250,这样一些票据需要等待规则放宽后才能匹配成功 : )map有两个枚举值:makomart 和 warehouse,比例为 100:100
4.3 运行模拟
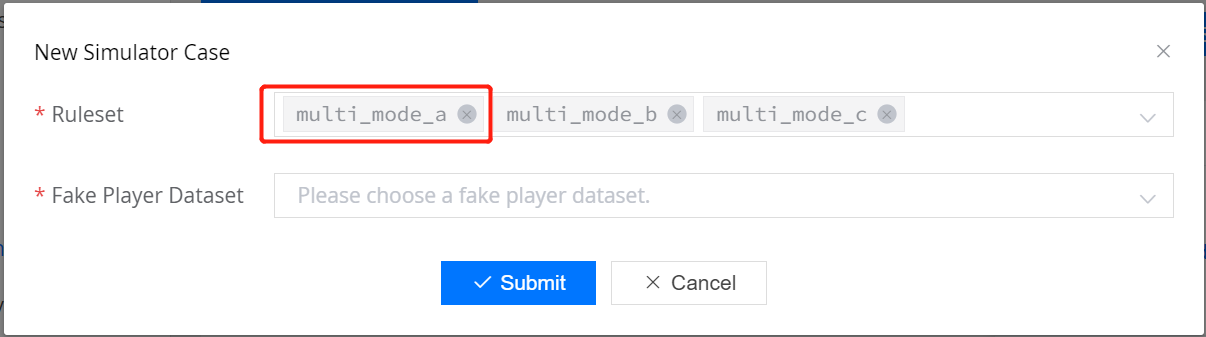
现在我们使用上述规则集和虚拟玩家数据集创建一个模拟案例。可以选择一个或多个规则集进行模拟。当选择多个规则集时,模拟器将遵循多规则集策略运行。其他字段保持默认即可。
案例会先进入队列,有空闲的服务实例后变为 Running。
4.4 解读结果
案例结束后,列表中会显示它的成功率和票据去向。点击 Details 打开结果页:
- 案例信息:规则集(附每个规则集的脚本快照)、数据集、入场与延迟设置、搜索超时、时长上限,以及实际使用的执行模式。Copy Summary 会把这些信息连同关键数字一起复制下来,便于分享。
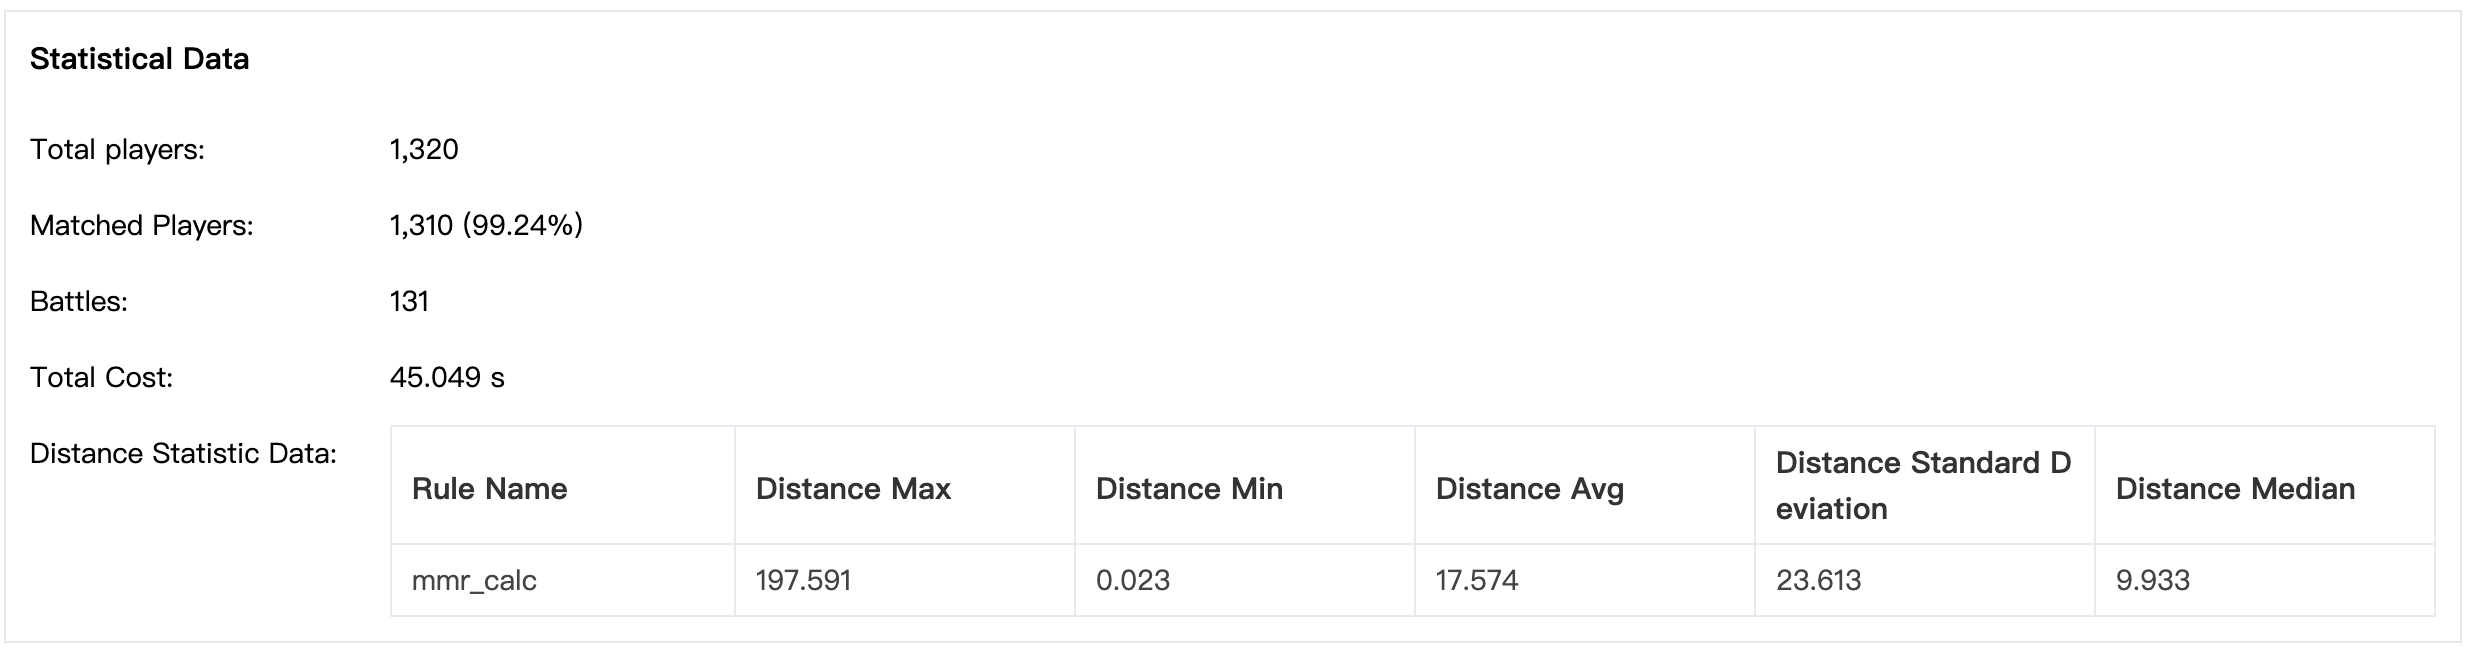
- Statistical Data:成功率、对局数、匹配成功的玩家数和耗时,以及票据去向:匹配成功(matched)、超时(timed out)、模拟结束时仍在匹配池中(left in pool)。模拟多个规则集时,还会用图表显示每个规则集促成的对局数。
- Simulator metrics:随模拟时间变化的曲线,包括每秒入场和出结论的票据数、匹配池积压量,以及匹配成功票据的等待时长。
- Why unmatched:点击某个去向或图表中的柱子,可以列出对应的票据。这里还会显示等待时长分布、票据在第几次规则放宽后匹配成功、成局对局的人数分布;玩家缺少延迟数据时会给出警告。
- Raw summary:模拟器写下的纯文本摘要,默认折叠。
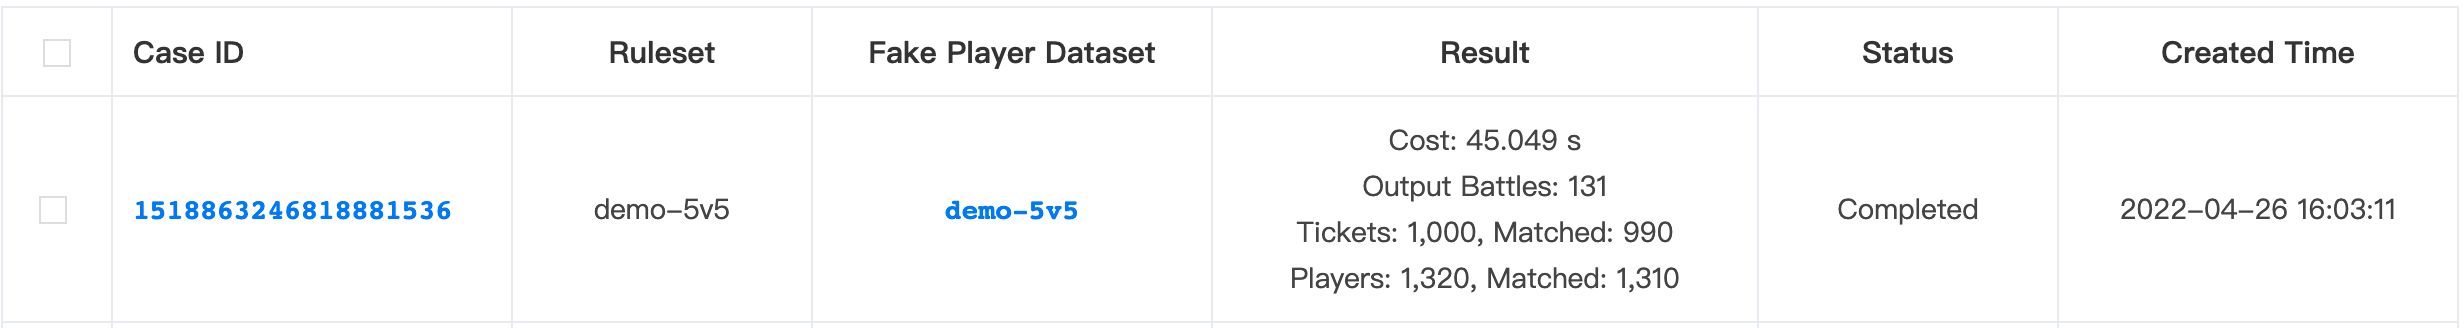
这些诊断信息可以帮助开发者评估每条规则的效果,例如距离规则在放宽之前是否过于严格。
5. 数据后处理
匹配结果可以导出为 csv 文件,每名玩家一行。未匹配成功的票据也包含在内,文件覆盖整个数据集。
前 11 列是预定义的,后面是每个有延迟数据的 region 各一列 latency.<region>,再后面是每个玩家属性各一列。
| 列 | 含义 |
|---|---|
ruleset_name | 促成该对局的规则集。票据未匹配成功时为空。 |
player_id | 玩家。 |
ticket_id | 玩家所属的票据,组队票据中的玩家共用同一个值。 |
battle_id | 票据被匹配进的对局。票据未匹配成功时为空。 |
team | 玩家被分到的队伍。票据未匹配成功时为空。 |
status | COMPLETED(匹配成功)、TIMEDOUT(达到搜索超时)或 LEFT(模拟结束时仍在匹配池中)。 |
enter_offset_ms | 票据进入匹配池的时间,即模拟开始后的毫秒数。 |
concluded_at_ms | 票据匹配成功或超时的时间,即模拟开始后的毫秒数。 |
wait_ms | 票据在匹配池中等待的时长,单位为毫秒。 |
anchor_count | 票据被选作候选对局中第一张票据的次数。 |
reput_count | 票据在尝试失败后被放回匹配池的次数。 |
latency.<region> | 玩家到该 region 的延迟,单位为毫秒。空单元格表示没有该 region 的延迟数据,与 0 不同。 |
ruleset_name,player_id,ticket_id,battle_id,team,status,enter_offset_ms,concluded_at_ms,wait_ms,anchor_count,reput_count,latency.Z1,latency.Z2,mmr,map
demo-5v5,player-713,ticket-545,3fe58d15-9193-41ad-9eba-545e3dc9e4bd,red,COMPLETED,899,1000,101,0,1,44,56,1786.863027,warehouse
demo-5v5,player-714,ticket-545,3fe58d15-9193-41ad-9eba-545e3dc9e4bd,red,COMPLETED,899,1000,101,0,1,45,57,2241.119114,warehouse
demo-5v5,player-116,ticket-84,3fe58d15-9193-41ad-9eba-545e3dc9e4bd,blue,COMPLETED,912,1000,88,0,0,61,39,1920.060106,warehouse
demo-5v5,player-711,ticket-543,a16ad3d0-dff1-4aae-8e5a-47826e1ad2d2,red,COMPLETED,15420,16000,580,1,3,52,70,1523.588655,makomart
,player-1301,ticket-990,,,TIMEDOUT,20242,50242,30000,6,62,,,2961.210000,makomart
...
在此格式之前创建的案例,保留其创建时的列(包含 reput_count 和 elapsed_ms,不包含 status 和各时间列)。
reput_count 是匹配系统的一个内部参数,为了尽可能暴露黑匣子内部的细节,帮助开发者理解自己编写的规则,reput_count 被导出。
在匹配系统中,票据保存在匹配池中,匹配器按需检索以找到匹配对象。匹配器会弹出 reput_count 最低的票据作为空对局中的第一张票据,然后根据规则的推导结果得出过滤条件,尝试填充剩余的位置。如果最终没有找到匹配对象,则将这些票据的 reput_count 增加并放回匹配池,等待下一次尝试。
因此,容易匹配的票据 reput_count 相对较低,反之亦然。一些超时的票据 reput_count 可能为 0。一般情况下,大部分票据的 reput_count 在 0~5 之间,平均值小于 1。
对于 reput_count 过高的情况,建议使用两种方法:
- 逐步放宽规则限制,降低匹配难度。
- 分模式创建规则集,让不同目标玩家使用不同的规则集。
wait_ms 是票据在匹配成功或超时前在匹配池中停留的时长。绘制 wait_ms 的直方图,可以看出哪些票据要等到规则放宽后才能匹配成功,从而平衡规则集的效率和精度。
enter_offset_ms 和 concluded_at_ms 把每张票据放到模拟的时间轴上,可以看到匹配池积压随时间的增长和消化。模拟按真实时间运行,票据的等待时长会随机器负载略有波动,因此请比较不同运行之间的差异,而不是关注精确的毫秒数。
通过利用 csv 数据,开发者可以:
- 绘制匹配耗时和玩家属性分布的直方图。
- 基于匹配数据研究聚类算法。
- 优化规则集设计,降低总体时间成本。
如果您对使用匹配模拟器有任何建议,请联系我们。